


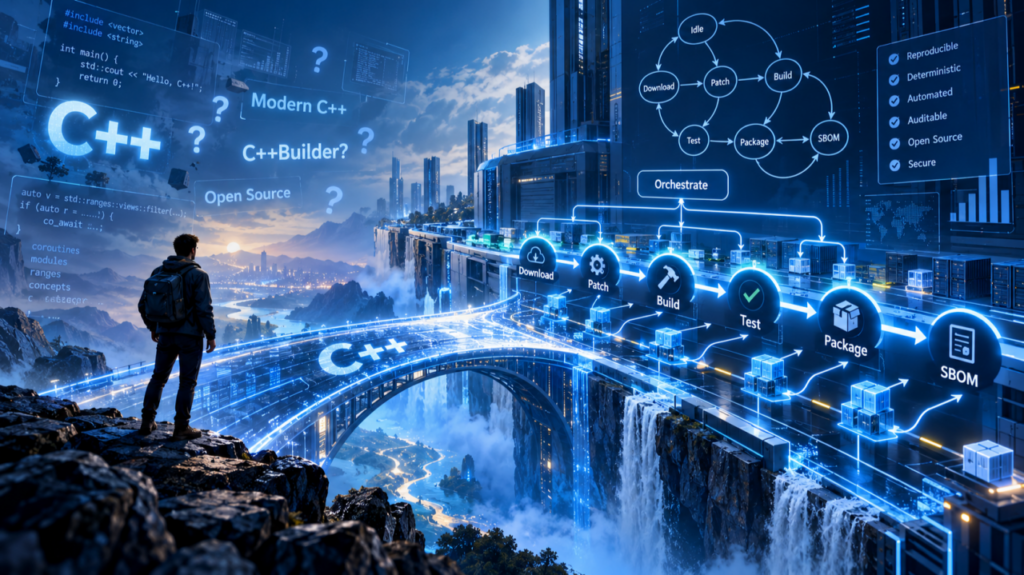
C++Builder wird in der breiten C++-Welt oft als eine Art Exot betrachtet. Manchmal wird das mit einem Lächeln gesagt, manchmal ganz ernsthaft. Dahinter verbirgt sich eine grundlegendere Frage: Inwieweit gehört eine Entwicklungsumgebung noch zum C++-Ökosystem, wenn viele der Bibliotheken, Werkzeuge und Arbeitsabläufe, die anderswo zur Selbstverständlichkeit geworden sind, nicht ohne Weiteres verfügbar sind?
Für mich geht diese Frage tiefer, als es auf den ersten Blick erscheinen mag.
C und C++ sind nicht bloß zwei Programmiersprachen unter vielen. Ein wesentlicher Teil der modernen IT-Infrastruktur basiert direkt oder indirekt auf ihnen. Betriebssysteme, Datenbanken, Netzwerkstacks, Compiler, Grafiksysteme, Laufzeitumgebungen, Kryptografie und unzählige grundlegende Bibliotheken würden ohne dieses Ökosystem in der Form, wie wir sie heute kennen, kaum existieren.
Projekte wie curl, zlib, OpenSSL, PostgreSQL, Skia oder Boost sind daher nicht einfach nur optionale Werkzeuge, die zufällig in einem Projekt nützlich sind. Viele von ihnen sind Teil des technischen Fundaments, auf dem andere Frameworks, Programmiersprachen und Anwendungen aufbauen.
Hierin sehe ich auch eine der entscheidenden Stärken von C++. Die Sprache deckt ein enormes Spektrum ab. Ich kann nah am Betriebssystem, am Speicher und an der Hardware arbeiten, etablierte C-APIs direkt nutzen und gleichzeitig hochabstrakte Modelle mit Templates, Concepts, Ranges und generischen Architekturen erstellen.
Diese Bandbreite wird manchmal unterschätzt, da Abstraktion stärker mit anderen Sprachen assoziiert wird. Ich halte diese Unterscheidung für irreführend. Moderne C++-Abstraktionen müssen sich nicht hinter Python oder anderen Hochsprachen verstecken. Die wahre Stärke liegt darin, dass ich von der Low-Level-Infrastruktur bis hin zu hochabstrakten Anwendungsmodellen in einer einzigen Sprache bleiben kann, ohne eine Sprachgrenze zu überschreiten, an der ich plötzlich die Kontrolle über Typen, Speicher, Laufzeitverhalten oder das zugrunde liegende System verliere.
Unsere eigene adecc-Bibliothek ist ein Beispiel für diesen Ansatz. Sie verbindet moderne C++-Konzepte mit Datenzugriff, Modellen und Benutzeroberflächen auf einer Abstraktionsebene, auf der ein Großteil des traditionellen Boilerplate-Codes entfallen kann. Das wird jedoch erst dann wirklich interessant, wenn diese Abstraktionen nicht in einer isolierten Welt für sich bleiben, sondern sich direkt in die bestehende IT-Landschaft einbinden lassen.
Deshalb ist der Zugang zum Open-Source-Ökosystem so wichtig.
Wenn ich curl, OpenSSL, PostgreSQL, XML-Parser, PDF-Bibliotheken, Grafiksysteme und die vielen anderen Bausteine direkt und unter meiner eigenen Kontrolle nutzen kann, gewinne ich mehr als nur einzelne Funktionen. Ich gewinne die Möglichkeit, meine eigenen Abstraktionen mit einem wesentlichen Teil der bestehenden IT-Welt zu verbinden.
Und genau dort hat diese Geschichte ihren Anfang genommen.
Es begann mit einem Livestream
In der ersten Augustwoche arbeiteten wir während eines meiner C++-Livestreams an einem Visual Studio-Projekt und benötigten curl, zlib und nlohmann-json. In dieser Umgebung war die Aufgabe fast schon unauffällig. Die Bibliotheken waren schnell konfiguriert, integriert, und wir hätten einfach weitermachen können.
Stattdessen drehte sich die Diskussion um C++Builder 13.
Warum war derselbe Vorgang dort nicht ebenso unkompliziert? Warum war eine Infrastruktur, die in anderen C++-Umgebungen zur Normalität geworden war, für C++Builder nicht ebenso selbstverständlich geworden? Und wenn C++Builder „C++“ im Namen trägt und nun eine moderne, auf Clang basierende Toolchain verwendet, sollte dann die umgebende C++-Welt nicht ebenso zugänglich sein?
Meine spontane Antwort war ganz klar: Diese Bibliotheken gehören in das GetIt-Paketmanagement und sollten von Embarcadero bereitgestellt und gepflegt werden.
Diese Ansicht festigte sich noch mehr, als ich mir das Embarcadero-Ökosystem selbst ansah. Delphi ist keineswegs losgelöst von dieser technischen Grundlage. Auch Embarcadero-Frameworks und -Bibliotheken nutzen Technologien, die aus der C- und C++-Welt stammen – manchmal direkt, manchmal durch Portierungen nach Delphi und manchmal in gemischter Form.
Daran ist an sich nichts auszusetzen. Wenn überhaupt, zeigt es, wie grundlegend diese Infrastruktur ist. Aber es wirft für mich auch eine naheliegende Frage auf: Warum sollte ein C++Builder-Entwickler über eine Delphi-Schicht auf eine ursprüngliche C- oder C++-Bibliothek zugreifen, wenn die Bibliothek direkt in C++ genutzt werden kann?
Wenn eine Bibliothek eine etablierte C- oder C++-API bereitstellt, möchte ich ihre Typen, Dokumentation, Beispiele und Community direkt nutzen. Ich möchte neuen Versionen des Originalprojekts folgen, anstatt davon abhängig zu sein, wann eine zusätzliche Abstraktionsschicht auf den neuesten Stand gebracht wird.
Die Diskussion im Stream ging daher über eine reine Frage der Bequemlichkeit hinaus. Sie führte zu einer viel einfacheren und schwierigeren Frage: War meine Erwartung technisch realistisch?
Bevor ich Embarcadero bat, diese Bibliotheken bereitzustellen, wollte ich wissen, ob sie tatsächlich mit der aktuellen Toolchain erstellt werden können.
Das wurde zum ersten Projekt.
August: Der Beweis, dass es möglich ist
Der Zweck dieses ersten Projekts war bewusst eng gefasst. Es sollte zeigen, ob sich aktuelle Open-Source-Bibliotheken mit C++Builder 13 und dessen bcc64x-Toolchain zuverlässig kompilieren lassen.
Ich hatte weder vor, einen neuen Paketmanager zu entwickeln, noch eine dauerhafte Infrastruktur für Drittanbieter aufzubauen. Das Ziel war der Nachweis.
Das klingt einfach. War es aber nicht.
Die Portierung großer Open-Source-Bibliotheken erfordert weit mehr als nur die Auswahl eines Compilers und das Drücken einer Build-Schaltfläche. Man muss Build-Systeme verstehen, der CMake-Logik folgen, die Compiler-Erkennung analysieren, Plattformzweige überprüfen, Abhängigkeiten verstehen, generierte Quelltexte begutachten und manchmal auch mehrere verschachtelte Build-Systeme durchschauen. Irgendwann braucht man außerdem genügend Erfahrung in C und C++, um zu erkennen, dass die am Ende eines Builds angezeigte Fehlermeldung möglicherweise mehrere konzeptionelle Ebenen von der tatsächlichen Ursache entfernt ist.
Das ist keine Arbeit, die jeder C++Builder-Entwickler leisten muss, und es ist auch keine Arbeit, die jeder Entwickler beherrschen muss. Ganz im Gegenteil. Ein Entwickler, der eine Datenbank, eine Grafikbibliothek oder eine Kryptografiekomponente benötigt, sollte diese nutzen können, ohne sich zuvor in die gesamte dahinterstehende Build-Maschinerie einarbeiten zu müssen.
Aber wenn ich beweisen wollte, dass der Weg technisch möglich war, musste ich diese Arbeit zunächst selbst erledigen.
Aus diesem Grund habe ich das Experiment nicht auf einige wenige, leicht zu handhabende Beispiele beschränkt. Boost 1.92 war Teil der ersten Runde, ebenso wie OpenGL, SDL2 und Raylib. Skia machte die Herausforderung erheblich anspruchsvoller, da Skia nicht einfach nur eine Bibliothek in einer Liste ist. Es bringt eine komplexe Landschaft aus internen und externen Abhängigkeiten, zusätzlichen Tools und eigenen Annahmen bezüglich Compilern, Plattformen und Build-Systemen mit sich.
Bis Ende August hatten wir mehr als zwanzig Bibliotheken erfolgreich kompiliert, wobei die tatsächlich betroffene Open-Source-Landschaft deutlich größer war, sobald man die internen Abhängigkeiten mitzählte.
Der Weg bis dahin verlief alles andere als reibungslos.
Es gab Höhepunkte, wenn eine Bibliothek nach stunden- oder tagelanger Untersuchung endlich fehlerfrei kompiliert werden konnte und sich bestätigte, dass die zugrunde liegende Idee stichhaltig war, und es gab Tiefpunkte, wenn ich viele Stunden mit Fehlern verbrachte, die zunächst kaum Sinn ergaben.
Zu den frustrierendsten Fällen gehörten jene, bei denen ein Projekt Borland- oder Embarcadero-bezogene Makros zwar korrekt erkannte, dann aber genau das Falsche tat. Alter Kompatibilitätscode aktivierte einen compilerspezifischen Pfad, der für eine völlig andere Generation von Toolchains geschrieben worden war.
Auf den ersten Blick erscheint das plausibel. Das Projekt erkennt Borland oder Embarcadero und wählt den entsprechenden Zweig aus. Erst wenn man den Verlauf der Toolchain und die Logik des Präprozessors im Detail nachverfolgt, wird deutlich, dass das moderne bcc64x technisch gesehen dem aktuellen Clang weitaus näher steht als den historischen Compilern, für die diese Pfade ursprünglich geschrieben wurden.
Ich habe viele Stunden in genau solchen Situationen verbracht, dabei gelegentlich Annahmen hinterfragt und manchmal Ansätze verworfen, die zunächst vielversprechend erschienen waren. Doch dadurch gewann jeder erfolgreiche Build auch an Bedeutung, denn jeder einzelne bestätigte, dass das grundlegende Problem nicht C++ selbst und auch nicht die grundlegende Leistungsfähigkeit des Compilers war.
Die Schwierigkeit lag oft in der Last der Geschichte.
Und genau deshalb wollte ich den Beweis erbringen.
Ich wollte mich nicht mit der Vorstellung abfinden, dass C++Builder als exotisch gelten sollte, nur weil der Zugang zur umgebenden Bibliothekswelt schwieriger war als bei anderen Toolchains. Ich war überzeugt, dass der moderne C++Builder technisch gesehen zum C++-Ökosystem gehört, und ich wollte das anhand echter Projekte demonstrieren, nicht mit Spielzeugbeispielen.
Ende August lag dieser Beweis für mich vor.
C++Builder ist nicht grundsätzlich von der modernen Open-Source-Welt abgeschnitten. Viele Projekte erfordern Anpassungen, manche Build-Systeme müssen korrigiert werden, und einige Annahmen im Quellcode passen nicht zur tatsächlichen Toolchain, aber das Ökosystem ist erreichbar.
Dadurch wurde das Projekt zu mehr als einem persönlichen Experiment.
Das wurde für Embarcadero zu einem Aufruf zum Handeln.
Ich habe nicht nur öffentlich darüber gesprochen. Ich habe E-Mails geschrieben und Antworten erhalten. Ich möchte hier nicht auf diesen Schriftwechsel eingehen, da der Kernpunkt wichtiger ist als die einzelnen Antworten.
Der technische Nachweis lag vor.
Es ist machbar.
Für mich bedeutet das, dass es keinen grundlegenden technischen Grund gibt, warum in Zukunft kein gepflegtes Angebot entstehen könnte – sei es über GetIt oder über eine andere geeignete Infrastruktur.
Ich bin nach wie vor der Meinung, dass dieser Punkt strategisch von Bedeutung ist. Beim direkten Zugang zum modernen C- und C++-Open-Source-Ökosystem geht es nicht einfach nur darum, weitere Pakete hinzuzufügen. Es beeinflusst, wie natürlich sich C++Builder innerhalb der breiteren C++-Welt positionieren kann.
Das war die erste Schlussfolgerung.
Die zweite war weniger erfreulich.
Der Beweis funktionierte.
Die Struktur jedoch nicht.
September: Von der Machbarkeit zur Reproduzierbarkeit
Bis Ende August hatte sich im ersten Projekt eine Vielzahl von CMake-Anpassungen, speziellen Parametern, Batch-Dateien, Patches, Hilfsprogrammen und projektspezifischen Vorgehensweisen angesammelt. Für ein Machbarkeitsprojekt war dies akzeptabel, da dessen Zweck darin bestand, nachzuweisen, dass der Weg technisch machbar war.
Als langfristige Lösung war dies jedoch nicht akzeptabel.
Es besteht ein grundlegender Unterschied zwischen dem einmaligen erfolgreichen Erstellen einer Bibliothek und der Fähigkeit, dasselbe Ergebnis Monate später auf einem anderen Rechner, nach einem Versionswechsel und unter denselben definierten Voraussetzungen zu reproduzieren.
Aus dem „Evidenz“-Projekt musste ein Projekt zur Reproduzierbarkeit werden.
An dieser Stelle setzte im September das zweite Projekt an.
Ich hätte abwarten können, ob sich aus dem „Evidence“-Projekt irgendwann anderswo etwas ergeben würde, aber das wollte ich nicht. Wir brauchten diese Infrastruktur für unsere eigenen Projekte, und das erste Projekt hatte bereits gezeigt, dass die technische Grundlage vorhanden war.
Also fing ich von vorne an.
Nicht, indem ich die alten Skripte erweiterte, sondern indem ich ein System für reproduzierbare Builds entwarf.
Dieses System wurde zur BuildEngine.
Die BuildEngine: mehr als nur ein Build-Skript
Die BuildEngine selbst wurde mit C++Builder geschrieben und nutzt bereits Teile derselben Open-Source-Welt, deren Integration die gesamte Diskussion ausgelöst hatte.
Ihr Kern ist eine endliche Zustandsmaschine (finite state machine, kurz FSM), doch die FSM ist nur ein Teil der Architektur.
Jede Bibliothek durchläuft eine definierte Abfolge von Zuständen, beginnend mit einem verifizierten Download und weiter über die Quellcode-Vorbereitung, das Patchen, die Konfiguration, den Build, den Test, die Installation, die Veröffentlichung und die Dokumentation. Das System beschreibt daher nicht mehr nur eine Liste von Befehlen. Es modelliert Zustände, Abhängigkeiten und die Kriterien, die bestimmen, ob ein Zustand gültig ist.
Gleichzeitig wurde die Engine so konzipiert, dass sie Aufgaben parallel ausführt.
Mehrere Worker verarbeiten unabhängige Aufgaben parallel, während ein separater Thread die von den verschiedenen Build-Systemen erzeugten Ausgaben analysiert und in eine kontrollierte Konsolendarstellung umwandelt. Wenn das zugrunde liegende Build-System die parallele Ausführung unterstützt, nutzt die BuildEngine dies ebenfalls, und dasselbe gilt für Testsuiten, die gleichzeitig ausgeführt werden können.
Dadurch verfügt das System über mehrere Ebenen der Parallelität, ohne jedoch die Kontrolle über die ablaufenden Vorgänge aufzugeben.
Das Testen wurde für mich ebenso wichtig.
Wann immer ein Projekt Upstream-Tests bereitstellt, führen wir diese durch. Ich gab mich nie damit zufrieden, dass eine Bibliothek zufällig kompiliert und verknüpft werden konnte. Wenn Tests fehlschlugen, wollte ich verstehen, warum. Ein Test wurde nur dann ausgeschlossen, wenn es einen klaren technischen Grund gab, warum er in unserer Umgebung nicht sinnvoll ausgeführt werden konnte, zum Beispiel weil er wirklich Linux-spezifisch war.
Diese Beharrlichkeit kostete Zeit, manchmal sehr viel Zeit, aber sie veränderte die Qualität des Ergebnisses. Ein erfolgreicher Build sagt mir, dass der Compiler den Code akzeptiert hat. Eine erfolgreiche Upstream-Testsuite sagt mir viel mehr darüber aus, ob sich die resultierende Bibliothek so verhält, wie es ihre Autoren beabsichtigt haben.
Und doch blieb all dies zunächst hinter einer sehr einfachen Oberfläche verborgen.
Die BuildEngine war eine Konsolenanwendung.
Wenn das Erscheinungsbild wichtiger wird als die Architektur
Diese scheinbar einfache Tatsache löste eine andere Art von Diskussion aus.
Einige Kritiker von C++ betrachteten die Konsolenschnittstelle und assoziierten sie sofort mit veralteter Technologie. Ein Konsolenprogramm war nach dieser Lesart fast schon per Definition altmodisch.
Ich fand diese Reaktion aufschlussreich.
Hinter dieser Konsole verbarg sich ein zustandsgesteuertes System mit mehreren Workern, mehrschichtiger Parallelität, asynchroner Ausgabeverarbeitung, Abhängigkeitsverfolgung, automatisierten Patches, Tests, Evidenzauswertung und der reproduzierbaren Erstellung einer gesamten Drittanbieter-Landschaft.
Doch nichts davon ist sichtbar, wenn man sich beim ersten Urteil allein auf das Äußere verlässt.
Diese Unterscheidung war für mich wichtig, weil sie eine allgemeinere Spannung rund um C++ selbst widerspiegelte. C++ wird manchmal eher anhand seiner sichtbaren Traditionen beurteilt als danach, was modernes C++ tatsächlich ausdrücken kann und was damit erstellte Systeme tatsächlich leisten können.
Für mich zählt der Inhalt mehr als die Fassade.
Dennoch hatte die Kritik einen nützlichen Effekt.
Sie veranlasste mich zu der Frage, wie viel von der Welt der BuildEngine verborgen bleiben sollte.
Und genau daraus entstanden der Server und der Manager.
Das System sichtbar machen
Der BuildEngine-Server wurde aus genau demselben Grund möglich, aus dem auch die BuildEngine selbst möglich geworden war: durch die Nutzung der Bibliotheken, die wir bereits in unser eigenes, kontrolliertes Ökosystem integriert hatten.
Das ist mir wichtig, denn der Server ist nicht bloß ein Web-Frontend, das zufällig neben dem Build-System steht. Er ist selbst ein weiterer Beweis dafür, dass die von uns entwickelten Bibliotheken in echten Anwendungen einsetzbar sind.
Für den HTTP- und den serverseitigen Bereich können wir boost::beast zusammen mit curl, OpenSSL, nlohmann-json und pugixml nutzen. Die Komprimierung und die Archivverwaltung basieren auf zlib, anderen Komprimierungsbibliotheken und libarchive. Die Markdown-Verarbeitung erfolgt über cmark-gfm, während Syntaxhervorhebung, Mermaid und MathJax über die entsprechenden JavaScript-Pakete integriert sind.
Das Ergebnis ist daher mehr als nur ein Server, der Webinhalte anzeigt. Es handelt sich um eine funktionierende Integration des Open-Source-Stacks, den die BuildEngine geschaffen hat.
Damit schließt sich ein weiterer Kreis: Die Bibliotheken sind nicht mehr nur vom System erzeugte Artefakte, sondern werden zur Grundlage, auf der die nächste Generation von Tools aufbaut.
Der Server stellt die von der BuildEngine erstellten Informationen in einer Form bereit, die navigierbar, überprüfbar, wiederverwendbar und verteilbar ist.
Ein Teil davon ist die Dokumentation.
Der Server verarbeitet Markdown und integriert Syntaxhervorhebung, Mermaid-Diagramme und MathJax, während er gleichzeitig eine Inhaltsverzeichnis-Funktion, Navigation und eine spezielle Druckansicht hinzufügt. Bauanleitungen, Architekturdokumentation, Lizenzen, technische Erläuterungen, Diagramme und Formeln können so Teil einer einheitlichen Dokumentationsumgebung werden.
Das mag wie eine reine Präsentation aussehen, dient aber einem tieferen Zweck. Bei der Reproduzierbarkeit geht es nicht nur um binäre Artefakte. Es geht auch darum, das Wissen rund um diese Artefakte verfügbar und verständlich zu machen.
Der Server stellt zudem eine REST-API für die Bibliothekslandschaft bereit.
Dadurch werden die Informationen für andere Tools zugänglich, da Bibliotheken, Versionen, Abhängigkeiten und Metadaten nicht mehr an eine einzige Benutzeroberfläche gebunden sind. Der Server kann bereits ausgewählte Bibliotheken zusammen mit ihren Abhängigkeiten bündeln und das resultierende Paket zum Download bereitstellen.
Der BuildEngine Manager befasst sich mit einem weiteren Aspekt des Problems.
Er wurde bewusst mit der VCL als Benutzeroberfläche entwickelt.
Diese Entscheidung ist bewusst getroffen worden. Ich möchte C++Builder nicht hinter einer fremden Frontend-Technologie verstecken. Wenn die Umgebung für moderne C++-Entwicklung geeignet ist, sollten die zugehörigen Tools dies auch direkt demonstrieren können.
Eine der Aufgaben des Managers besteht darin, sich mit Sicherheitsbefunden zu befassen. Er liest Informationen über bekannte Sicherheitsprobleme ein, ermöglicht die Überprüfung und Klassifizierung von CVEs und anderen Befunden und speichert diese Bewertungen, damit sie zusammen mit den Informationen über die betroffenen Bibliotheken weitergegeben werden können.
Dies ist ein Bereich, in dem eine grafische Benutzeroberfläche wirklich nützlich ist. Ein Build-System kann Sicherheitsinformationen zwar automatisch sammeln und miteinander verknüpfen, doch die Entscheidung, ob ein Befund relevant ist, akzeptiert wird, gemildert wurde oder Maßnahmen erfordert, ist letztendlich eine menschliche Einschätzung.
Der Manager stellt diese Ebene bereit.
An dieser Stelle wurde auch die Interaktion rund um das Projekt besonders interessant.
Auf der einen Seite standen die C++Builder-Entwickler, die kein Interesse an theoretischen Debatten darüber hatten, ob das Ökosystem überhaupt existieren sollte. Sie wollten Lösungen. Sie brauchten einsatzfähige Bibliotheken, vorhersehbare Builds und einen Weg, der nicht jeden Entwickler dazu zwang, dieselben Probleme mit der Toolchain immer wieder neu zu entdecken.
Auf der anderen Seite standen Kritiker von C++, die die sichtbare Fassade vorschnell beurteilten, während die Architektur und der dahinterstehende technische Aufwand für sie unsichtbar blieben.
Beide Reaktionen beeinflussten das Projekt auf unterschiedliche Weise.
Die erste Gruppe bestätigte, warum die Arbeit notwendig war.
Die zweite erinnerte mich daran, dass gute Technik nicht immer selbsterklärend ist.
Die Lösung der tatsächlichen Integrationsprobleme
Je tiefer ich mich in die Bibliotheken vertiefte, desto deutlicher wurden die sich wiederholenden technischen Muster.
Ein wesentlicher Teil der Integrationsprobleme entsteht nicht, weil C++Builder grundsätzlich nicht in der Lage ist, eine Bibliothek zu kompilieren, sondern weil ein Projekt die Toolchain falsch klassifiziert.
bcc64x basiert auf Clang. Gleichzeitig gibt es Kompatibilitätsdefinitionen und Strukturen, die GNU- oder MinGW-Umgebungen ähneln. Manche Projekte erkennen eines dieser Merkmale und schließen sofort darauf, dass es sich um MinGW handelt, woraufhin sie einen Build-Pfad aktivieren, der eigentlich nicht zur Umgebung passt.
Die tatsächliche Kombination ist interessanter. Wir haben einen modernen Clang-Compiler, eine GNU-ähnliche C++-Standardbibliotheksumgebung und gleichzeitig die Windows-Laufzeitumgebung sowie UCRT. Zudem gibt es spezifische Merkmale in der von Embarcadero ausgelieferten Umgebung, darunter problematische Importe, die wir bereits während des Bootstraps kontrolliert korrigieren.
Aus diesem Grund findet eine zentrale Anpassung statt, bevor der Build einzelner Bibliotheken beginnt. Ihr Zweck besteht nicht darin, bcc64x in MinGW zu verwandeln, sondern zu verhindern, dass Projekte von Drittanbietern die Toolchain aufgrund einzelner Kompatibilitätsmarker in den falschen Zweig zwingen.
Das gleiche Prinzip gilt für die historische Borland-Unterstützung in den Bibliotheksquellcodes. Bestehender Kompatibilitätscode ist manchmal genau das, was einen modernen Build zum Scheitern bringt, da er eine Compiler-Generation beschreibt, die dem aktuellen bcc64x nicht mehr ähnelt.
Sobald ich diese Muster verstanden hatte, konnte ich aufhören, jeden Misserfolg als isoliertes Problem zu betrachten.
Sie wurden Teil der Infrastruktur.
Patches, XML und kontrollierte Build-Definitionen
Es gibt nach wie vor Bibliotheken, die tatsächliche Änderungen am Quellcode erfordern.
Diese Änderungen sind keine manuellen Korrekturen.
Die erforderlichen Patches sind Teil der Build-Definition. Sie werden versioniert, überprüft und automatisch angewendet, sodass das System weiß, welche Änderung zu welcher Bibliotheksversion gehört und unter welchen Bedingungen sie erforderlich ist.
Ein funktionierender Quellcode-Baum ist daher nicht mehr das Ergebnis persönlicher Erinnerung oder manueller Bearbeitung. Er lässt sich aus definierten Quellen rekonstruieren.
Das gleiche Prinzip gilt für den Workflow.
Ich wollte nicht, dass das zweite Projekt zu einer weiteren Sammlung immer weiter wachsender Skripte wird, daher sind die Prozesse und Parameter der einzelnen Bibliotheken deklarativ in XML beschrieben.
Die Beschreibung legt fest, woher ein Paket stammt, welche Version verwendet wird, wie der Download überprüft wird, welche Abhängigkeiten bestehen, welche Vorbereitungsschritte erforderlich sind, welche Patches angewendet werden und wie die einzelnen Phasen ausgeführt werden.
Eine zweite XML-Beschreibung definiert die gesamte Build-Landschaft.
Das System ist bewusst nicht auf CMake beschränkt. In der realen Open-Source-Welt kommen verschiedene Build-Systeme zum Einsatz, daher arbeitet die BuildEngine auch mit Meson und MPC, während Python und Perl dort zu kontrollierten Bestandteilen der Umgebung werden, wo ein Projekt sie benötigt.
Ich wollte keine CMake-Engine schreiben.
Ich wollte eine Engine, die in der Lage ist, eine Open-Source-Landschaft nachzubilden.
Eine Bibliothek ist mehr als nur eine Binärdatei
Das Projekt hat auch mein Verständnis davon verändert, wann eine Bibliothek tatsächlich fertig ist.
Am Anfang war eine erfolgreiche Verknüpfung schon ein Erfolg.
Das reicht heute nicht mehr aus.
Nach dem Build werden die Artefakte installiert und in einer definierten Struktur veröffentlicht. Lizenzinformationen werden ermittelt und hinzugefügt, die Herkunft der Quellen und die Versionen bleiben nachvollziehbar, und es wird eine SBOM generiert.
In einem professionellen Umfeld ist das unerlässlich. Sobald eine CVE auftaucht, reicht es nicht aus, zu wissen, dass OpenSSL irgendwo verwendet wird. Ich muss wissen, welche Version vorhanden ist, woher sie stammt und welche Komponenten davon abhängen.
Diese Informationen gehören zum Artefakt.
Das Gleiche gilt für die Dokumentation.
Wo es sinnvoll und technisch möglich ist, wird die Doxygen-Dokumentation direkt aus der exakten Quellcode-Revision generiert, die zur Erstellung der Bibliothek verwendet wurde, sodass die Dokumentation zum Artefakt gehört und nicht auf eine beliebige, nicht relevante aktuelle Version im Internet verweist.
Die endliche Zustandsmaschine stellt zudem sicher, dass diese Arbeit nicht grundlos wiederholt wird.
Ein erfolgreicher Build ist ein Beweis an sich. Wenn sich der Quellcode nicht geändert hat und die relevanten nachgelagerten Zustände weiterhin gültig sind, wäre es sinnlos, alles neu zu kompilieren. Reproduzierbarkeit bedeutet nicht, jedes Mal alles erneut zu tun. Es bedeutet, genau erklären zu können, warum ein bestehender Zustand noch gültig ist oder warum er neu erstellt werden muss.
Dieses Konzept wurde zu einem der wichtigsten Bestandteile der BuildEngine.
Vom Build-System zum nutzbaren Ökosystem
Aus den mehr als zwanzig Bibliotheken des „August Evidence“-Projekts ist mittlerweile ein Stack mit über vierzig Bibliotheken geworden. Das Spektrum reicht von Netzwerken über Kryptografie, Komprimierung, Datenbanken, XML-Verarbeitung, Grafik und PDF-Verarbeitung bis hin zu weiterer Infrastruktur, einschließlich der entsprechenden Abhängigkeiten und unterstützenden Tools.
Für mich ist diese Bandbreite wichtig, weil sie den ursprünglichen Proof in etwas viel Praktischeres verwandelt.
Die Bibliotheken bleiben nicht als Demonstrationsobjekte auf der Strecke. Das BuildEngine-Ökosystem nutzt seinen eigenen Third-Party-Stack, und der Server ist vielleicht das deutlichste Beispiel für diesen Übergang, da er selbst aus den Bibliotheken aufgebaut ist, die das gesamte Projekt bereitstellen wollte.
Damit schließt sich ein Kreis.
Aber noch nicht der wichtigste.
In der ursprünglichen Diskussion im Livestream ging es nicht darum, wie interessant es wäre, Bibliotheken zu erstellen.
Es ging darum, wie ein C++Builder-Entwickler sie einfach nutzen könnte.
Und genau hier kommt der StackBuilder ins Spiel.
Die Lücke schließen: vom Build zum einsatzbereiten Paket
Der StackBuilder nimmt die veröffentlichten Artefakte und stellt daraus definierte Stacks von Drittanbietern für konkrete Projekte zusammen.
Ein Projekt kann nicht nur festlegen, welche Bibliotheken es benötigt, sondern auch, welche genauen Versionen zu seiner Build-Umgebung gehören. Der resultierende Stack kann auf kontrollierte Weise gepackt, verteilt und in ein Repository integriert werden.
Damit ist die Lücke aus der ursprünglichen Diskussion endlich geschlossen.
Der Entwickler muss nicht mehr wissen, wie Boost, OpenSSL, PostgreSQL, Skia oder eine ihrer Abhängigkeiten erstellt wurden. Die schwierige Arbeit wurde bereits upstream unter kontrollierten und reproduzierbaren Bedingungen erledigt.
Was das Projekt erhält, ist ein einsatzbereites Paket.
Das Repository weiß, welchen Drittanbieter-Stack es erwartet. Der Stack kann in einer definierten Form bereitgestellt, bei Bedarf wiederhergestellt und direkt in den Build integriert werden.
An diesem Punkt schließt sich der Kreis der gesamten Geschichte.
Anfang August lautete die Frage, warum ein Visual-Studio-Projekt etablierte C++-Bibliotheken fast selbstverständlich nutzen konnte, während diese Erfahrung in C++Builder fehlte.
Das erste Projekt bewies, dass die Bibliotheken kompiliert werden können.
Das zweite Projekt verwandelte dieses Wissen in eine reproduzierbare Infrastruktur.
Der Server und der Manager machten die Landschaft sichtbar, überprüfbar und verwaltbar und zeigten vor allem, dass die Bibliotheken selbst bereits als Grundlage für echte Anwendungen dienen konnten.
Der StackBuilder wandelt das Ergebnis nun in das um, was Entwickler tatsächlich benötigen: fertige, definierte und direkt integrierbare Pakete von Drittanbietern.
Und für mich ist das nach wie vor der zentrale Punkt des gesamten Projekts.
C++Builder sollte nicht als Außenseiter in der C++-Welt behandelt werden, nur weil der Weg in diese Welt schwieriger war, als er sein sollte. Der Compiler gehört dorthin. Die Bibliotheken können erstellt werden. Die Infrastruktur kann aufgebaut werden. Die verbleibende Frage ist, wie selbstverständlich diese Welt den Entwicklern zur Verfügung gestellt wird.
Deshalb gilt der ursprüngliche Aufruf an Embarcadero nach wie vor.
Die Arbeit sollte nicht von jedem C++Builder-Entwickler unabhängig voneinander wiederholt werden müssen. Diese Entwickler brauchen Lösungen, und sie sollten sie auch bekommen.
Vorerst haben wir unseren eigenen Weg geschaffen – von der verifizierten Quelle zum reproduzierbaren Build, vom getesteten Artefakt zur Dokumentation und zu Sicherheitsmetadaten sowie von der veröffentlichten Bibliothek zum Repository-fähigen Drittanbieter-Stack.
Weitere Informationen dazu werden in Kürze folgen.